Vì sao CLAUDE.md cứ phình to mãi? Hiện tượng "catastrophic remembering" trong agentic coding
Nếu bạn từng dùng Claude Code, Cursor, hay GitHub Copilot cho một dự án đủ lâu, có thể bạn đã nhận ra: file CLAUDE.md, AGENTS.md, hay copilot-instructions.md của bạn chỉ có xu hướng dài ra. Bạn thêm một chỉ dẫn để sửa một lỗi cụ thể, rồi thêm một chỉ dẫn khác cho tình huống edge-case khác, và cứ thế — cho tới khi file dài đến mức không ai còn nhớ vì sao một nửa số dòng trong đó tồn tại, nhưng cũng không ai dám xoá vì sợ agent lại tái phạm lỗi cũ. Bài báo “Why Does CLAUDE.md Keep Growing? Catastrophic Remembering in Agentic Coding” của Kushal Chakrabarti (South Park Commons) định lượng chính xác hiện tượng này, tìm ra nguyên nhân gốc rễ, và đề xuất một cách sửa đơn giản đến bất ngờ.
Đặt tên cho vấn đề: catastrophic remembering
Trong continual learning, catastrophic forgetting là hiện tượng mạng nơ-ron học nhiệm vụ mới thì ghi đè mất kiến thức đã học từ nhiệm vụ cũ. Tác giả đặt tên cho hiện tượng đối nghịch xảy ra với các file chỉ dẫn agentic: catastrophic remembering — người bảo trì (hoặc chính agent) giữ lại những gì lẽ ra nên xoá, đơn giản vì không còn ai nhớ lý do ban đầu để đánh giá liệu chỉ dẫn đó còn cần thiết hay không.
Cốt lõi của lập luận nằm ở một phép tính chi phí bất đối xứng: thêm một chỉ dẫn tốn O(1) — chỉ cần gõ thêm vài dòng — nhưng xoá một chỉ dẫn một cách an toàn, không gây hồi quy (regression), tốn O(2^|D|) với |D| là số chỉ dẫn hiện có trong file. Lý do: để biết một chỉ dẫn có thực sự “thừa” hay không, về nguyên tắc bạn phải thử tắt nó đi và kiểm tra mọi tổ hợp còn lại — vì có thể hai chỉ dẫn nào đó tưởng như độc lập nhưng cùng nhau che phủ cho một trường hợp mà chỉ mình chúng cộng lại mới đủ (thuộc tính “redundancy” trong bài báo). Không có công cụ nào brute-force nổi phép thử đó khi file đã có vài chục chỉ dẫn, nên trên thực tế, cách xoá duy nhất khả thi là… không xoá gì cả.
Bằng chứng từ 1.867 repository thực tế
Nhóm tác giả xây dựng một corpus gồm 1.867 repository GitHub có chứa CLAUDE.md, AGENTS.md, hoặc copilot-instructions.md, theo dõi 299.440 lượt chuyển phiên bản và tách được 247.694 vòng đời chỉ dẫn riêng lẻ (không chỉ đo kích thước file tổng thể, mà theo dõi từng chỉ dẫn ra đời và biến mất khi nào). Vài con số đáng chú ý:
- File trung bình có 39 chỉ dẫn ở phiên bản cuối cùng được theo dõi (percentile 90 lên tới 131) — vượt xa ngưỡng mà các nghiên cứu khác đã chỉ ra là điểm bắt đầu suy giảm khả năng tuân thủ chỉ dẫn của LLM.
- Trong số 1.576 repository có nhiều phiên bản, 64,3% có xu hướng tăng số chỉ dẫn, chỉ 26,6% giảm — mức tăng ròng trung vị là +7 chỉ dẫn.
- Loại trừ các đợt rewrite hàng loạt, mỗi commit trung bình thêm ròng +4,9 chỉ dẫn.
- Trong suốt vòng đời một file, số lượng chỉ dẫn tăng tới +226% — và đây không phải do nội dung dịch chuyển từ phần “payload” sang phần “chỉ dẫn”: tổng kích thước file cũng tăng +140%.
“The Ratchet”: tăng trưởng, rewrite, rồi tăng trưởng nhanh hơn
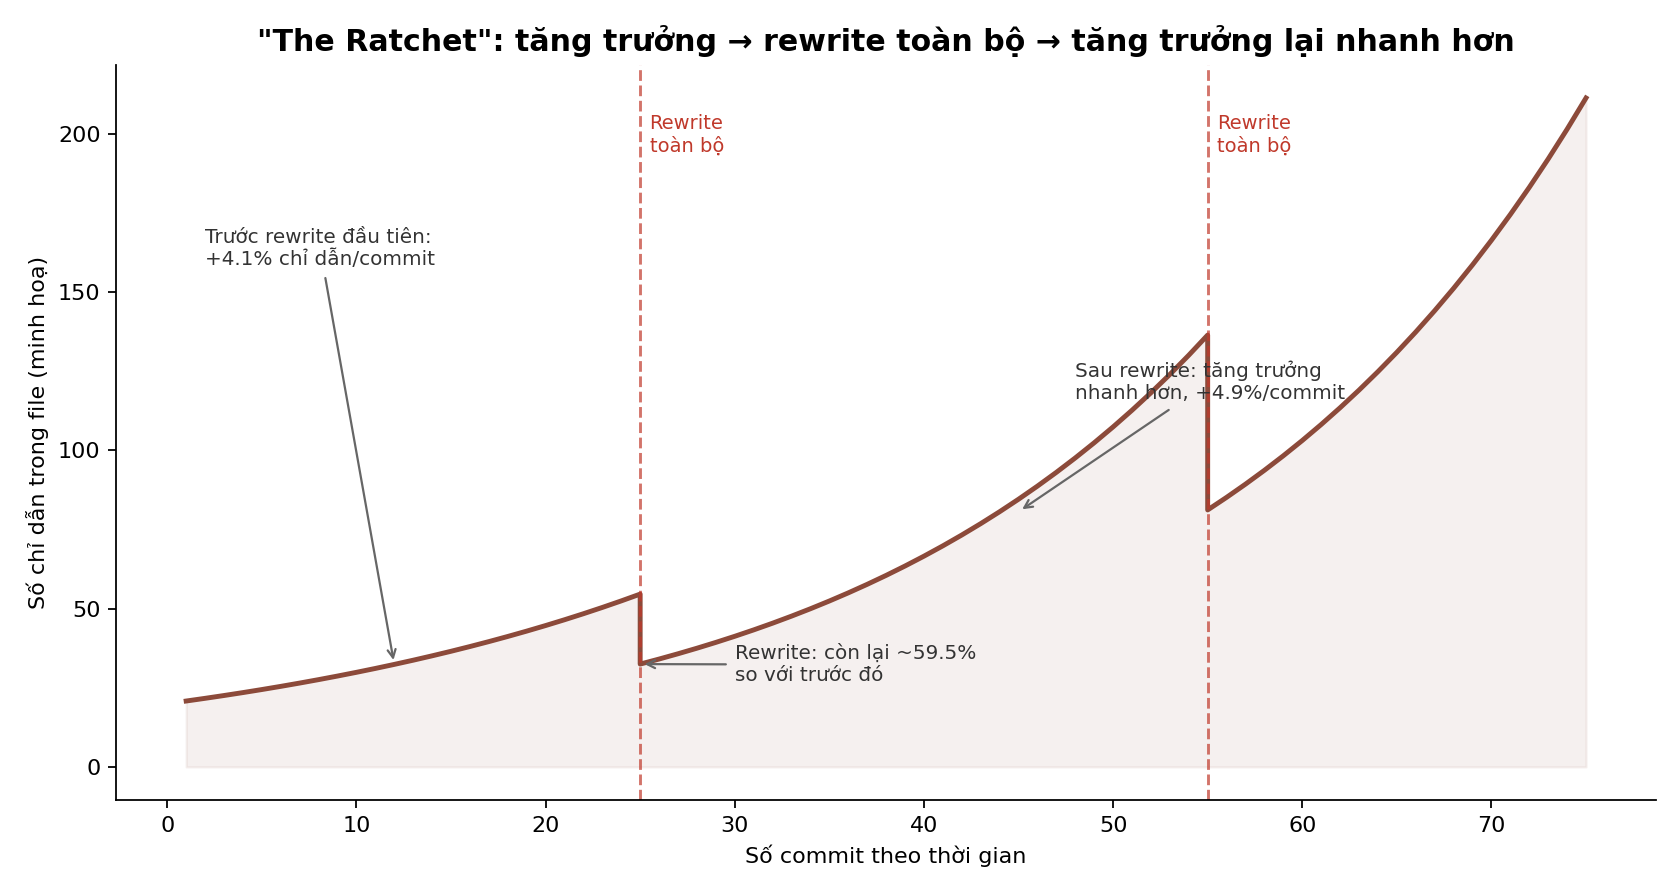
Điều thú vị là cách các file này “giảm” kích thước: 76,8% các trường hợp chỉ dẫn biến mất xảy ra trong một commit duy nhất xoá sạch quá nửa file — tức là gần như không ai xoá từng chỉ dẫn riêng lẻ, mà chỉ có hành động “đập đi làm lại” toàn bộ. Điều này giải thích vì sao các nghiên cứu trước đây quan sát diff dòng lệnh (line diff) luôn thấy “số lượt xoá cực hiếm” mà không lý giải được — vì họ không tách được việc viết lại một chỉ dẫn khỏi việc xoá nó thật sự.
Đáng nói hơn: rewrite toàn bộ không giải quyết được nguyên nhân gốc. Khi căn chỉnh các file theo thời điểm rewrite đầu tiên của chúng, số chỉ dẫn trung bình giảm còn 59,5% ngay sau khi rewrite — nhưng chỉ trong 10 commit tiếp theo đã phục hồi lên 91,5% so với trước đó. Tệ hơn, tốc độ tăng trưởng sau rewrite (+4,9%/commit) còn nhanh hơn trước rewrite (+4,1%/commit) — tạo thành một đường cong hình răng cưa mà tác giả gọi là “the ratchet” (cái cóc — cơ cấu chỉ quay được một chiều).
Đâu là nguyên nhân thật sự?
Bài báo kiểm định ba giả thuyết cạnh tranh nhau bằng cách phân tích deletion hazard — xác suất một chỉ dẫn bị xoá tại một độ tuổi (số commit) nhất định:
- Instruction staleness (chỉ dẫn lỗi thời): nếu đúng, hazard phải tăng theo tuổi — chỉ dẫn càng cũ càng dễ bị coi là lỗi thời và bị xoá.
- Content fragility (chỉ dẫn dễ vỡ chết sớm, chỉ dẫn bền vững tồn tại lâu): nếu đúng, cũng khiến hazard giảm theo tuổi, nhưng thuần tuý do hiệu ứng thành phần (composition effect).
- Imperfect recall (mất trí nhớ về lý do): dự đoán hazard giảm theo tuổi, và — khác biệt quan trọng — giảm nhanh hơn khi có nhiều tác giả cùng sửa file.
Dữ liệu thực tế cho thấy deletion hazard giảm theo tuổi với độ dốc log-hazard -0,032/commit (khoảng tin cậy 95%: [-0,047, -0,019], không chứa 0) — loại trực tiếp giả thuyết staleness. Khi kiểm soát bằng mô hình gamma frailty để loại trừ hiệu ứng thành phần của content fragility, độ dốc vẫn giữ ở mức -0,0355, gần như không đổi — loại luôn giả thuyết thứ hai. Cuối cùng, bằng chứng quyết định: hazard giảm mạnh hơn khi file có nhiều tác giả cùng sửa (hệ số tương tác giữa tuổi và số tác giả = -0,021, z = -11,7) — điều mà chỉ riêng imperfect recall mới có thể dự đoán, vì càng nhiều người luân phiên chỉnh sửa, “trí nhớ tập thể” về lý do ban đầu của một chỉ dẫn càng phân mảnh và biến mất nhanh hơn.
Giải pháp: comment — điều mà kỹ thuật phần mềm đã giải quyết từ lâu
Đây là phần thú vị nhất của bài báo: engineering software đã có sẵn công cụ cho đúng vấn đề này — comment, văn bản dành cho người bảo trì kế tiếp và vô hình với trình thông dịch. Quy ước lâu đời trong lập trình là ghi lại lý do (why), không phải cách làm (how) hay nội dung (what). Tác giả đặt câu hỏi: nếu “tiếng Anh là code mới”, vì sao chúng ta chưa có comment cho nó?
Để kiểm chứng, nhóm tác giả xây dựng một testbed mới gọi là Inverse-IFEval: đảo ngược bộ benchmark tuân thủ chỉ dẫn IFEval để tạo ra các “thế giới” mà bộ chỉ dẫn tối ưu (minimum cover) đã biết trước — điều bình thường không thể tính toán được. Trong testbed này, một “maintainer” (có thể là agent) phải tự học lại bộ chỉ dẫn đúng qua nhiều vòng, chỉ dựa trên phản hồi nhiễu và bị che khuất từ một “executor” — và được phép (hoặc không được phép) để lại comment ghi lại lý do đằng sau mỗi chỉ dẫn cho vòng lặp kế tiếp.
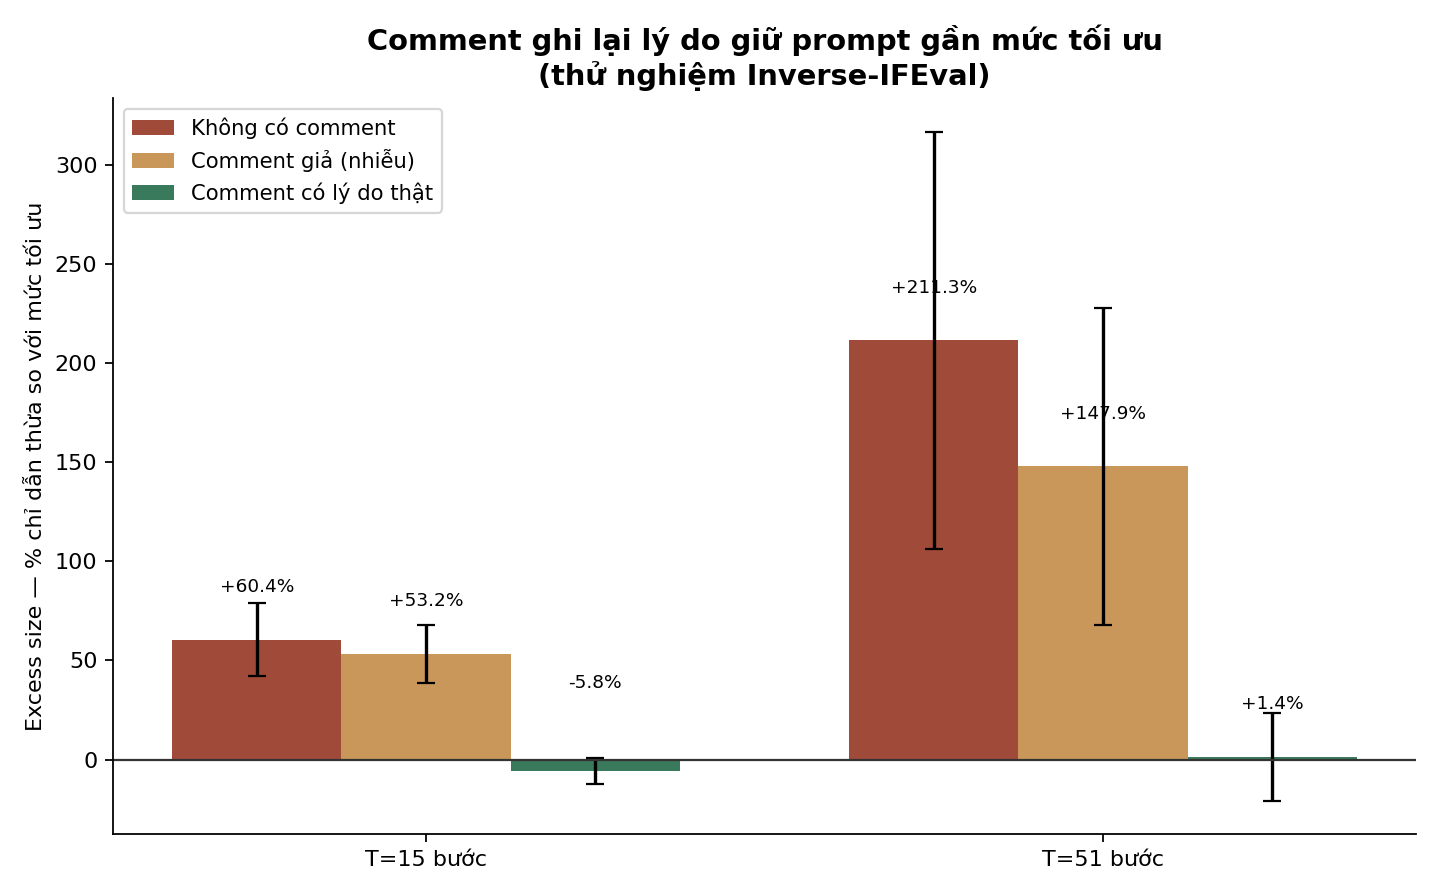
Kết quả rất rõ ràng: so với việc không có comment (excess size — phần chỉ dẫn thừa so với mức tối ưu — lên tới +60,4% sau 15 bước và +211,3% sau 51 bước), maintainer được để lại comment ghi lý do thật giữ prompt gần mức tối ưu nhất — -5,8% sau 15 bước và chỉ +1,4% sau 51 bước, tức giảm 99,3% phần dư thừa. Một nhóm đối chứng quan trọng — “comment giả” chỉ có hình dạng giống comment nhưng không mang thông tin thật — cho kết quả gần như không khác gì không có comment, chứng minh rằng chính nội dung lý do, không phải chỉ riêng sự hiện diện của comment, mới là yếu tố quyết định.
Comment không chỉ giúp prompt gọn hơn — còn giúp agent tuân thủ tốt hơn
Một câu hỏi tự nhiên: liệu comment chỉ giúp số lượng chỉ dẫn giảm, hay còn cải thiện chất lượng tuân thủ thực tế? Nhóm tác giả kiểm tra bằng cách đảo ngược một benchmark khác — WildIFEval, gồm các yêu cầu thực tế của người dùng — và cố tình trộn thêm các chỉ dẫn “nhiễu” (lấy ngẫu nhiên từ yêu cầu của người khác) vào cùng một prompt. Kết quả: 16 chỉ dẫn nhiễu làm giảm tỷ lệ tuân thủ đúng các chỉ dẫn thật từ 65,6% xuống còn 41,5% — một cái giá rất đắt cho sự “rác” tích tụ trong file chỉ dẫn.
Khi để maintainer dùng comment qua 3 vòng bảo trì, tỷ lệ tuân thủ phục hồi từ 50,4% lên 62,0% — tương đương cải thiện tương đối 23,1% so với maintainer không dùng comment trên cùng một prompt. Hiệu ứng này được xác nhận lại (replicate) với một LLM giám khảo thứ hai độc lập, cho kết quả nhất quán.
Vì sao điều này quan trọng
Thông điệp cốt lõi của bài báo rất thực dụng: các nhà phát triển công cụ agentic coding có thể bổ sung cú pháp comment cho file chỉ dẫn — một kênh riêng, tách biệt khỏi nội dung mà executor thực sự đọc, chỉ dành để ghi lại: chỉ dẫn này được thêm vì lỗi gì, giả thuyết sửa là gì, và kết quả ra sao. Bản thân tác giả cũng lưu ý một rủi ro quan trọng khi áp dụng phát hiện này vào thực tế: viết comment ghi lại lý do là hành động an toàn (không xoá gì), nhưng tự động hoá việc xoá chỉ dẫn dựa trên comment thì không — một hệ thống tự động làm việc này có thể xoá nhầm chỉ dẫn có lý do chính đáng. Khuyến nghị của tác giả là luôn giữ con người trong vòng lặp quyết định xoá, và không áp dụng tự động cho các chỉ dẫn liên quan tới an toàn cho tới khi được kiểm chứng kỹ hơn.
Nhìn rộng hơn, bài báo là một lời nhắc khéo léo: nhiều vấn đề của “lập trình bằng tiếng Anh” trong kỷ nguyên agentic coding đã từng được kỹ thuật phần mềm giải quyết từ hàng chục năm trước — chỉ là chúng ta chưa kịp mang các bài học đó sang định dạng mới. Câu trả lời cho catastrophic remembering, như tác giả kết luận, “đã 40 năm tuổi và ở ngay lĩnh vực bên cạnh” — vấn đề chỉ là có chịu mượn lại hay không.
Đang tải bình luận…